- Оценка ROI при оцифровке методы обоснования бюджета на сканирование документов
- Оцифровка данных как проститься с бумажными документами
- Аутсорсинг оцифровки документов: стоит ли делегировать сканирование и ретроконверсию?
- Архивисты об оцифровке взгляд изнутри
- Качество оцифровки документов: что предлагают рынок сканирования и индексирования?
- Гарантия на оцифровку документов: как застраховать бизнес от потери данных и ошибок подрядчика
- Роль заказчика в оцифровке: как избежать срыва сроков и роста бюджета
- Оптимизация бюджета на оцифровку: 5 рабочих способов снизить стоимость оцифровки
- Оцифровка музейных коллекций: технологии работы с экспонатами и учетной документацией
- Библиотека искусств: оцифровка стала фактором методологической эволюции
- МГОМЗ: Технологии оцифровки дают музейным работникам творческий импульс
- Оцифровка библиотечных фондов: технологии сканирования книг и ретроконверсии каталогов
- Оцифровка архивных фондов: технологии сканирования и ретроконверсии исторических документов
- Оцифровка видео- и аудиопленок: технологии сохранения кинопленочного наследия
- Выбор подрядчика для оцифровки документов: чек-лист для руководителей и архивистов
- Формирование бюджета на оцифровку: как избежать скрытых расходов и точно спрогнозировать смету
- Технологии оцифровки документов: полный обзор методов сканирования и ретроконверсии
- Окупаемость СЭД: почему внедрение системы не заканчивается подписанием актов?
- Выездное сканирование документов: как организовать оцифровку без вывоза архива из офиса
- Оцифровка конфиденциальных данных: стандарты безопасности и защиты
- Оцифровка земельных и имущественных документов: от рутины к доходам бюджета
- Сканировать или фотографировать: как выбрать оптимальную технологию оцифровки
- Архитектура участка сканирования: от локального ввода до распределенных центров обработки
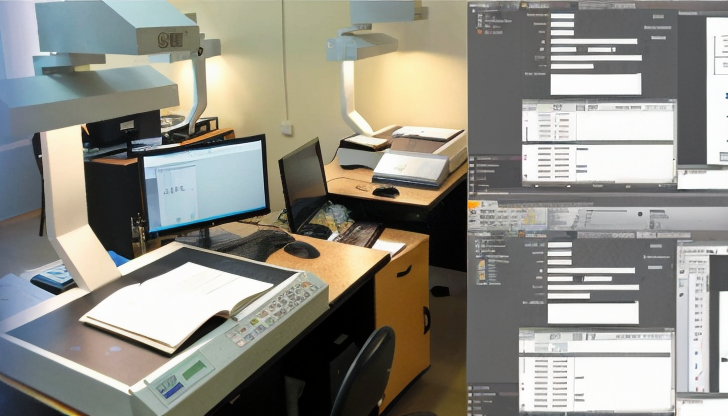
Ежедневное насыщение корпоративных информационных систем (ИС) данными требует выстроенного процесса текущего ввода. Это может быть как одиночное рабочее место в бухгалтерии, так и глобальная ИТ-инфраструктура для потокового сканирования, распознавания и индексирования.
С каждым годом объемы оцифровки растут, и классическая связка «планшетный сканер + ПК» уступает место сложным программно-аппаратным комплексам (ПАК).
01
Анатомия современного участка ввода
По оценке экспертов корпорации ЭЛАР, именно грамотная конфигурация следующих компонентов определяет совокупную стоимость владения (TCO) и операционную эффективность:
- Парк сканеров (для расшитых и сшитых массивов).
- ПО для потоковой обработки графических образов.
- Серверы оптического распознавания текста (OCR).
- Модули индексирования и экспорта метаданных в целевые ИС.
02
Подбор сканирующего оборудования: математика нагрузки
Выбор техники диктуется физическими параметрами носителей и прогнозируемым объемом. Для стандартной управленческой и бухгалтерской «первички» (где скрепки легко удаляются) оптимальны документные (потоковые) сканеры.
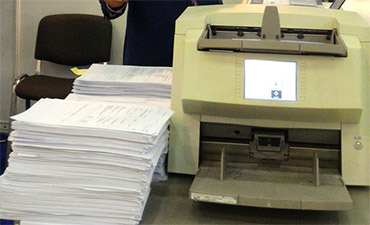
Предприятие с потребностью в 10 000 листов в день приобрело три офисных сканера (по 51 000 ₽, ресурс 2 500 листов/сутки). Из-за хронических перегрузок и неравномерного распределения задач за два года компания 21 раз обращалась в сервис (превышение лимитов фиксируется внутренним счетчиком и снимает случай с гарантии). Итоговые затраты вместо плановых 153 000 ₽ достигли 657 000 ₽, а суммарный простой превысил три месяца. За эти средства можно было приобрести одну старшую профессиональную модель, которая работала бы без сбоев.
Офисный аппарат за ~50 000 ₽ рассчитан на 3 000 листов в сутки и служит около года (общий ресурс ~1 млн стр.). Перегрев ведет к царапинам на стекле, замена которого крайне дорога. Поэтому ФНС, ФТС и Сбербанк используют исключительно промышленные комплексы, рассчитанные на миллионы страниц.
Сшитые документы и нестандартные форматы: Здесь царят планетарные сканеры (на базе профессиональных матриц или фотоаппаратов). Скорость лимитируется эргономикой и навыками оператора. Для форматов больше А1 и ветхих оригиналов (карты, чертежи) применяются широкоформатные протяжные сканеры с защитными конвертами или комплексы высококачественного сканирования (КВС) с бесконтактной оптикой. Внедрение такого оборудования требует обязательного обучения персонала.
Интеграция с учетными системами и автоматизация рутины
Базовый сценарий — обособленное рабочее место специалиста. Современное ПО часто встроено в сам сканер: оно на лету выравнивает перекосы, удаляет пустые страницы, корректирует цвет и сшивает многостраничные PDF. Оператору остается лишь загрузить пакет в СЭД или ERP (в 80% случаев через штатный интерфейс с заполнением карточки).
03
Автоматическое индексирование: где проходит граница возможностей?
Стремление исключить ручной труд и человеческие ошибки делает автоиндексирование стандартом рынка. Но технология работает только с качественными печатными формами (точность OCR >99%). Рукописи и дефектные оригиналы дают слишком много брака.
Шаблонное распознавание: На образ накладывается цифровая матрица с зонами интереса. Текст, попавший в зону, извлекается по заданным правилам. Идеально для формализованных (счета, накладные) и условно-формализованных (договоры, приказы) бланков. Рынок предлагает множество решений с разной тарификацией, поэтому предварительное тестирование нескольких вендоров помогает существенно сэкономить.
Семантический анализ текста: «Умные» алгоритмы ищут сущности по контексту и совокупности признаков, не требуя жесткой привязки к координатам на листе. Отраслевой показательный пример: в 2013 году благодаря технологиям анализа текста, разработанным корпорацией ЭЛАР, Главархив Москвы смог в автоматическом режиме извлечь массивы персоналий и адресов из правоустанавливающих документов, избежав колоссальных затрат на ручное индексирование.
Альтернатива для сложных текстов: Если качество печати низкое, применяется OCR без структурированного индексирования. Документы загружаются в базу с возможностью полнотекстового поиска, где ошибки распознавания компенсируются алгоритмами нечеткого (fuzzy) поиска.
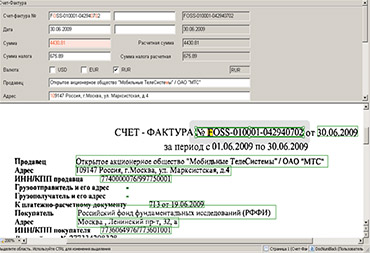
Исторический прецедент: еще в 2005 году для РФФИ было внедрено решение, автоматически извлекавшее данные из бухгалтерской первички и формировавшее проводки без участия человека. Сегодня подобные проекты исчисляются сотнями.
04
Распределенный ввод и модель ОЦО
Если у бизнеса множество территориально разнесенных точек ввода, дублировать лицензии и ПО на каждой площадке экономически нецелесообразно. Решение — централизация на базе Объединенных центров обслуживания (ОЦО).
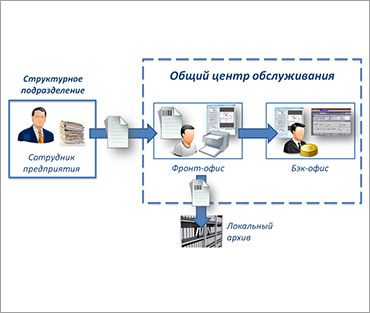
Кейс «ФосАгро» (2015 г.): Классическая архитектура бухгалтерского ОЦО. В Череповце размещен бэк-офис (квалифицированные бухгалтеры), а в филиалах — фронт-офисы с минимальным штатом для приема бумаг.
Технологический контур: Во фронт-офисах комплекты документов маркируются штрих-кодами, прокладываются листами-разделителями и пропускаются через потоковые сканеры. Специалист на месте заполняет лишь базовые атрибуты пакета (контрагент, сумма, маршрут) и отправляет цифровые копии в бэк-офис. Физическая бумага остается в локальном архиве.
Бухгалтер бэк-офиса мгновенно получает скан-образы, проводит операции (часть полей подтягивается автоматически), а файлы уходят в электронный архив, жестко линкуясь с проводками через штрих-код. Признак комплекта гарантирует, что пакет документов всегда можно собрать воедино. Грамотная инфраструктура позволила «ФосАгро» достичь целевых KPI по операционной экономии и скорости закрытия периодов.
05
Резюме
Проектирование участка ввода не терпит дилетантства. Подбор оптики, настроек OCR, логики штрих-кодирования и интеграционных шлюзов требует привлечения профильных интеграторов с подтвержденным опытом внедрения.
Смотрите также