- Индексирование и извлечение данных: архитектура создания поисковых баз данных
- Консалтинг и аудит процессов: как спроектировать оцифровку и внедрение ИТ-систем
- Облачное индексирование: удаленная ретроконверсия и работа с электронным архивом
- Оцифровка конфиденциальных документов и гостайны: стандарты безопасности и деперсонификация
- Комплексные системы хранения документов: от ECM-платформ до физических архивов
- Оснащение участков сканирования: комплексная автоматизация ввода данных «под ключ»
- Передача электронного ресурса и гарантийные обязательства: финальный этап оцифровки
- Комплексная подготовка бумажных архивов: от систематизации до реставрации и внеофисного хранения
- Распределенные системы ввода: архитектура сканирования и доставки документов для ОЦО и филиальных сетей
- Технологии сканирования документов: выездные бригады и стационарные производственные центры
Облачное индексирование представляет собой специализированный сервис, в рамках которого интегратор извлекает метаданные из скан-копий документов, передаваемых заказчиком или загружаемых в защищенную облачную инфраструктуру.
Общая схема оказания услуг
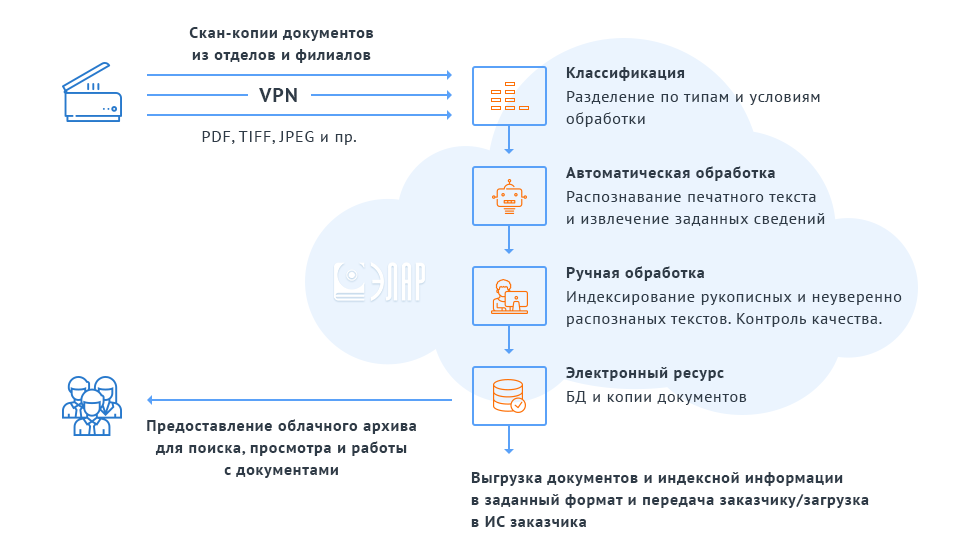
Процесс ретроконверсии в облаке разделен на четыре последовательных технологических этапа, каждый из которых может быть гибко адаптирован под задачи конкретного бизнеса.
Этап 1
Загрузка и маршрутизация документов
Массивы принимаются в любом графическом или текстовом формате. Критическим условием для недорогой автоматической обработки является качество исходных изображений. Приоритетными параметрами выступают разрешение 300 dpi и цветной режим (RGB). Материалы более низкого качества также будут гарантированно проиндексированы, однако снижение точности полнотекстового распознавания неизбежно повлечет за собой рост доли ручных операций и увеличение стоимости контракта.
Интегратор поддерживает любые удобные каналы загрузки:
- Передача по электронной почте, факсу, через мессенджеры и мобильные приложения.
- Ручная выгрузка в облачный архив или согласованную FTP-папку (включая организацию защищенных VPN-туннелей).
Для автоматизации потоковой обработки группы документов и отдельные листы при сканировании разграничиваются специальными листами-разделителями или идентифицируются посредством штрих-кодов (наклейка или прямая печать на бланке). Специалисты ЭЛАР оказывают полную консультационную поддержку при внедрении подобных механизмов, что позволяет кратно упростить и удешевить последующую обработку.
Этап 2
Автоматическая классификация и предобработка
Поступившие скан-образы проходят через конвейер специализированного программного обеспечения ЭЛАР:
- Графические файлы приводятся к стандартному виду: выполняется доворот по тексту, обрезка лишних краев
- Алгоритмы определяют начало и конец документа, выделяют приложения (при их наличии), исключают пустые и неинформативные листы
- Производится полнотекстовое распознавание и идентификация типа документа, который задает логику дальнейшей обработки
- Скан-образы каждого документа компилируются в единый файл (по умолчанию формируется многостраничный PDF с текстовой подложкой).
Документы, не прошедшие автоматическую классификацию, обрабатываются вручную. Согласно производственной статистике, при хорошем качестве печати доля таких исключений составляет не более 0,7%.
Этап 3
Извлечение данных и верификация
Из каждого документа извлекается требуемый набор реквизитов. Индексированию подлежит любая информация, расположенная в любом месте бланка: номера, даты, ФИО, наименования юридических лиц, ИНН, суммы и т.д.
Процесс извлечения значимых данных максимально автоматизирован. Для формализованных документов применяются методы шаблонного распознавания, для нестандартных — разработанные ЭЛАР интеллектуальные алгоритмы поиска ключевых слов, фраз и символов.
Информация, не поддающаяся машинному извлечению (рукописный или плохо читаемый текст, дефекты сканирования), автоматически направляется в очередь операторам ввода. Операторы также выполняют функцию верификации — выборочного или полного контроля качества автоматического индексирования.
Вся обработка осуществляется исключительно в облачной инфраструктуре. Сотрудники ЭЛАР получают доступ к данным через специализированный АРМ с жестко ограниченным функционалом. При работе с персональными данными и конфиденциальной информацией обязательно применяются технологии деперсонификации.
Этап 4
Результат и интеграция
Стандартным вариантом сдачи работ является сохранение подготовленного электронного информационного ресурса (ЭИР) в «Облачном архиве».
Заказчик получает полную свободу в распоряжении данными и цифровыми копиями:
- Хранение массивов в облаке с возможностью удаленного поиска и работы в режиме 24/7.
- Выгрузка в требуемом машиночитаемом формате (XML, DBF, Access и др.) для последующего импорта в корпоративные информационные системы.
- Разработка кастомных интеграционных сервисов для автоматической загрузки данных в локальные или облачные учетные контуры заказчика.
По запросу подготовленная база данных может быть передана любым другим удобным для клиента способом.
Смотрите также